Skip to content

第011期-机会成本 ​

机械之手指向夜空烟花

成本是放弃了的最大代价。

看烟花!!! ​

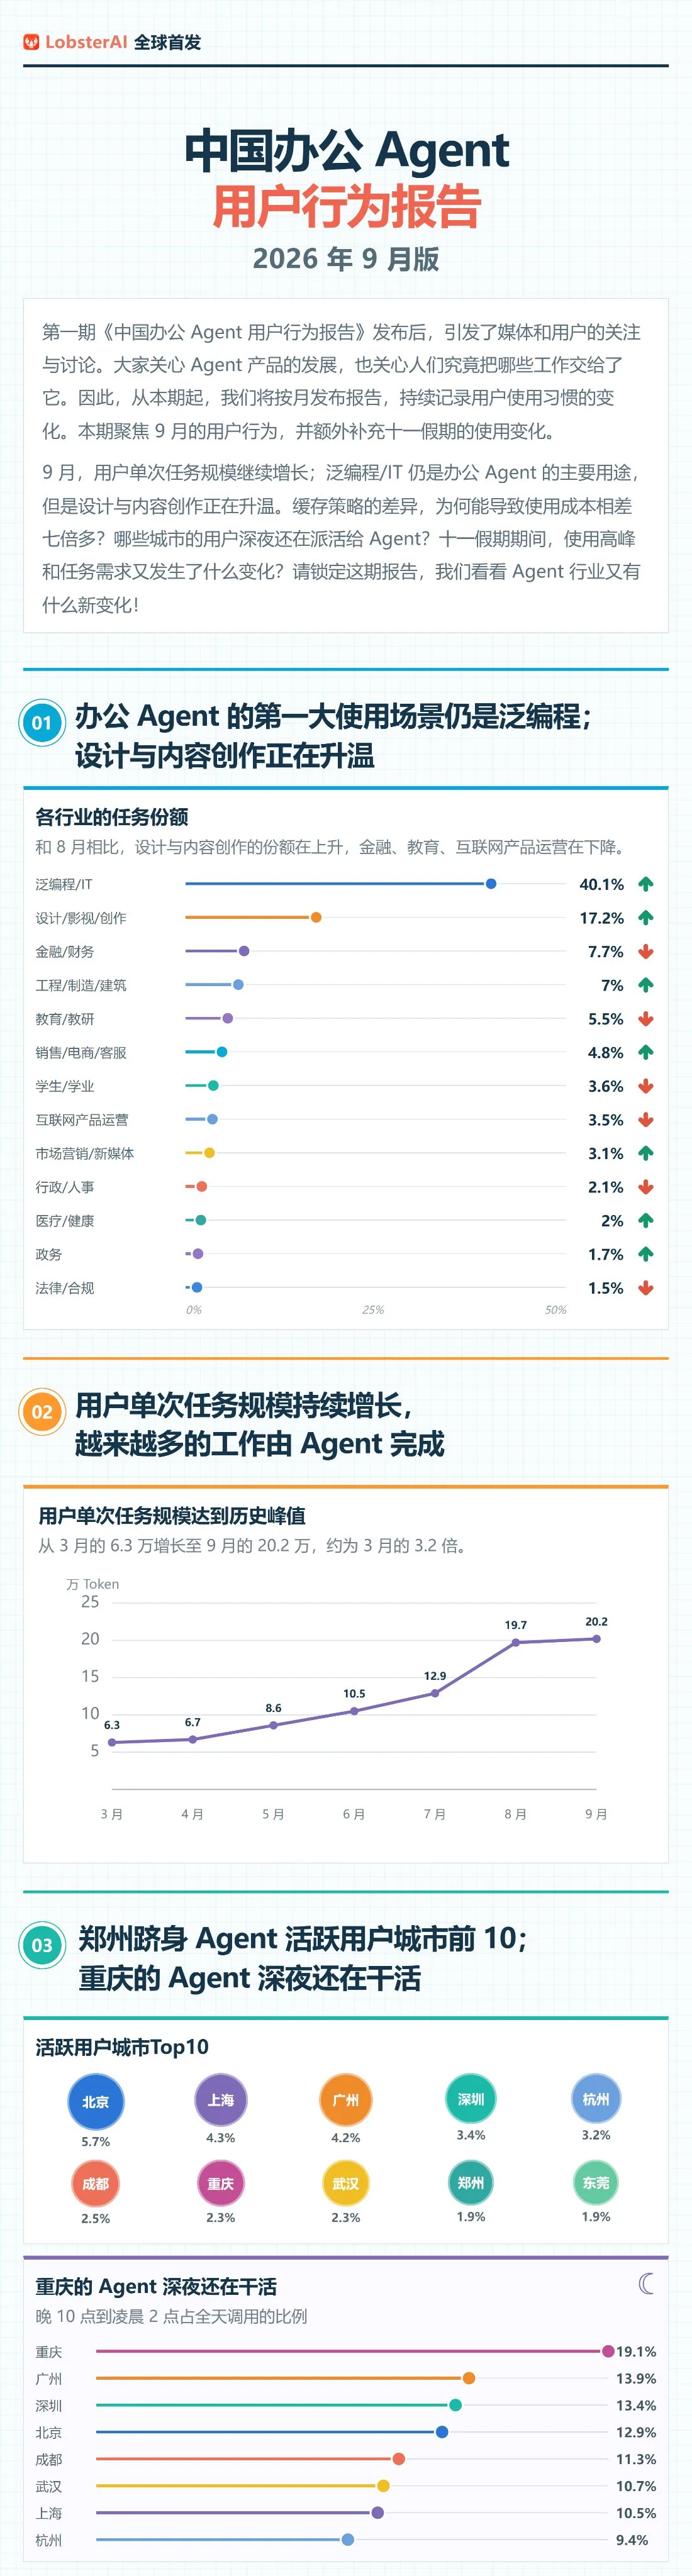
中国办公 Agent 用户行为报告 9月

中国办公 Agent 用户行为报告 9月

《中国办公 Agent 用户行为报告》2026年9月版(LobsterAI)的有趣发现提炼:

1. 场景:编程仍是绝对主力,但设计/创作在升温 ​

  • 泛编程/IT 仍占 40.1%(环比上升),是第一大场景。
  • 设计/影视/创作 升至 17.2%,成为第二大用途,升温明显。
  • 金融/财务、教育、电商、互联网运营等传统场景份额在下降,工程制造、行政人事、政府略有上升。

2. 任务越来越“重”:单次任务规模暴涨 ​

  • 从3月的 6.3万 tokens 增长到9月的 20.2万 tokens,约 3.2倍。
  • 用户越来越敢把复杂、长周期的工作直接丢给 Agent。

3. 城市与深夜行为很有意思 ​

  • 活跃用户城市 Top10:北京(5.7%)、上海、广州、深圳、杭州、成都、南京、武汉、郑州(1.9%)、东莞。郑州首次进入前十。
  • 重庆用户深夜最“卷”:晚上10点到凌晨2点的调用占比高达 19.1%,远超广州(13.9%)、深圳(13.4%)等城市。

4. 微信是绝对主力入口,早高峰靠IM派活 ​

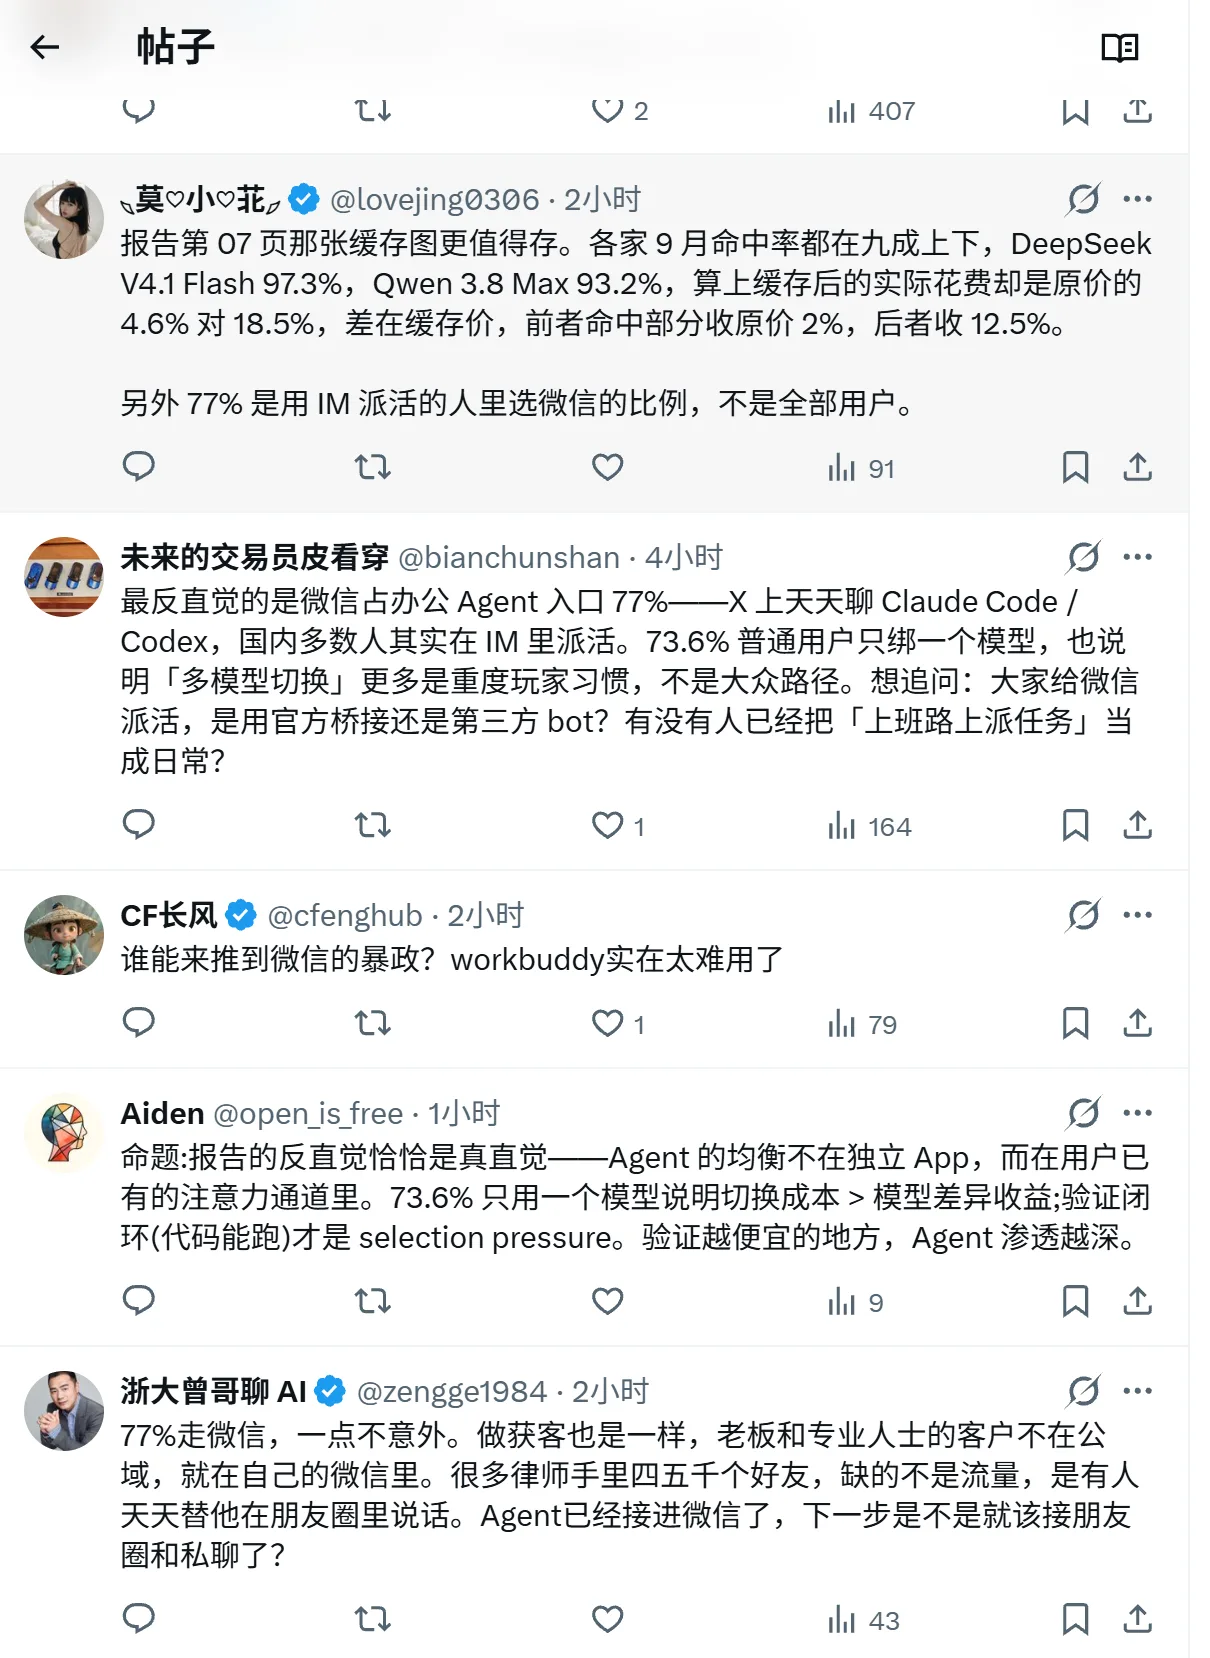
  • IM 派活渠道:微信 77%、飞书 14.3%、QQ 6.5%、企业微信 5%。
  • 早上 7-11点,用户更喜欢通过 IM(而非桌面)给 Agent 派活,很多是通勤时就开始安排工作。

5. 国庆假期节奏明显变化 ​

  • 使用高峰从日常的下午4点左右,推迟到晚上10点。
  • 凌晨0-7点份额从13%升到17%,白天玩、晚上回来用 Agent 干活的特征明显。
  • 假期中 泛编程/IT 份额反而上升(+4.0%),学习教育、个人生活事务也上升;数据表格、翻译润色等下降。

6. 模型使用习惯与“省钱”差异巨大 ​

  • 近七成普通用户只用 1个模型,重度用户平均用 2.4个(更爱搭配)。
  • DeepSeek V4 系列缓存命中率极高(多在95%+),实际费用可低至原价的 4.6%~7.5%。
  • 对比:Qwen 约18.5-18.8%、Kimi 20.2%、GLM 29.6-35.1%。缓存策略差异可导致成本相差数倍甚至更多。

7. 模型厂商份额变化 ​

  • 智谱 GLM 环比 暴增约166.7%(新模型带动)。
  • DeepSeek 基本持平,Qwen、MiniMax、Kimi 都出现明显下滑。

8. 图像/视频生成:豆包 Seed 系列称王 ​

  • 图像生成:豆包 Seedream 57.2%。
  • 视频生成:豆包 Seedance 54.4%。
  • 两者都超过一半份额。

9. 用户规模在加速增长 ​

  • 月度日均活跃用户持续上升,9月环比增长约 83%。

一句话总结:Agent 已经从“能对话”走向“真干活”,任务越来越重、使用越来越日常(微信+早高峰+深夜重庆),而模型层面的缓存与成本优化正在成为关键差异点。设计/创作场景的崛起和假期使用模式的变化,也显示出它正在渗透更广泛的办公与生活场景。
中国办公 Agent 用户行为报告 9月

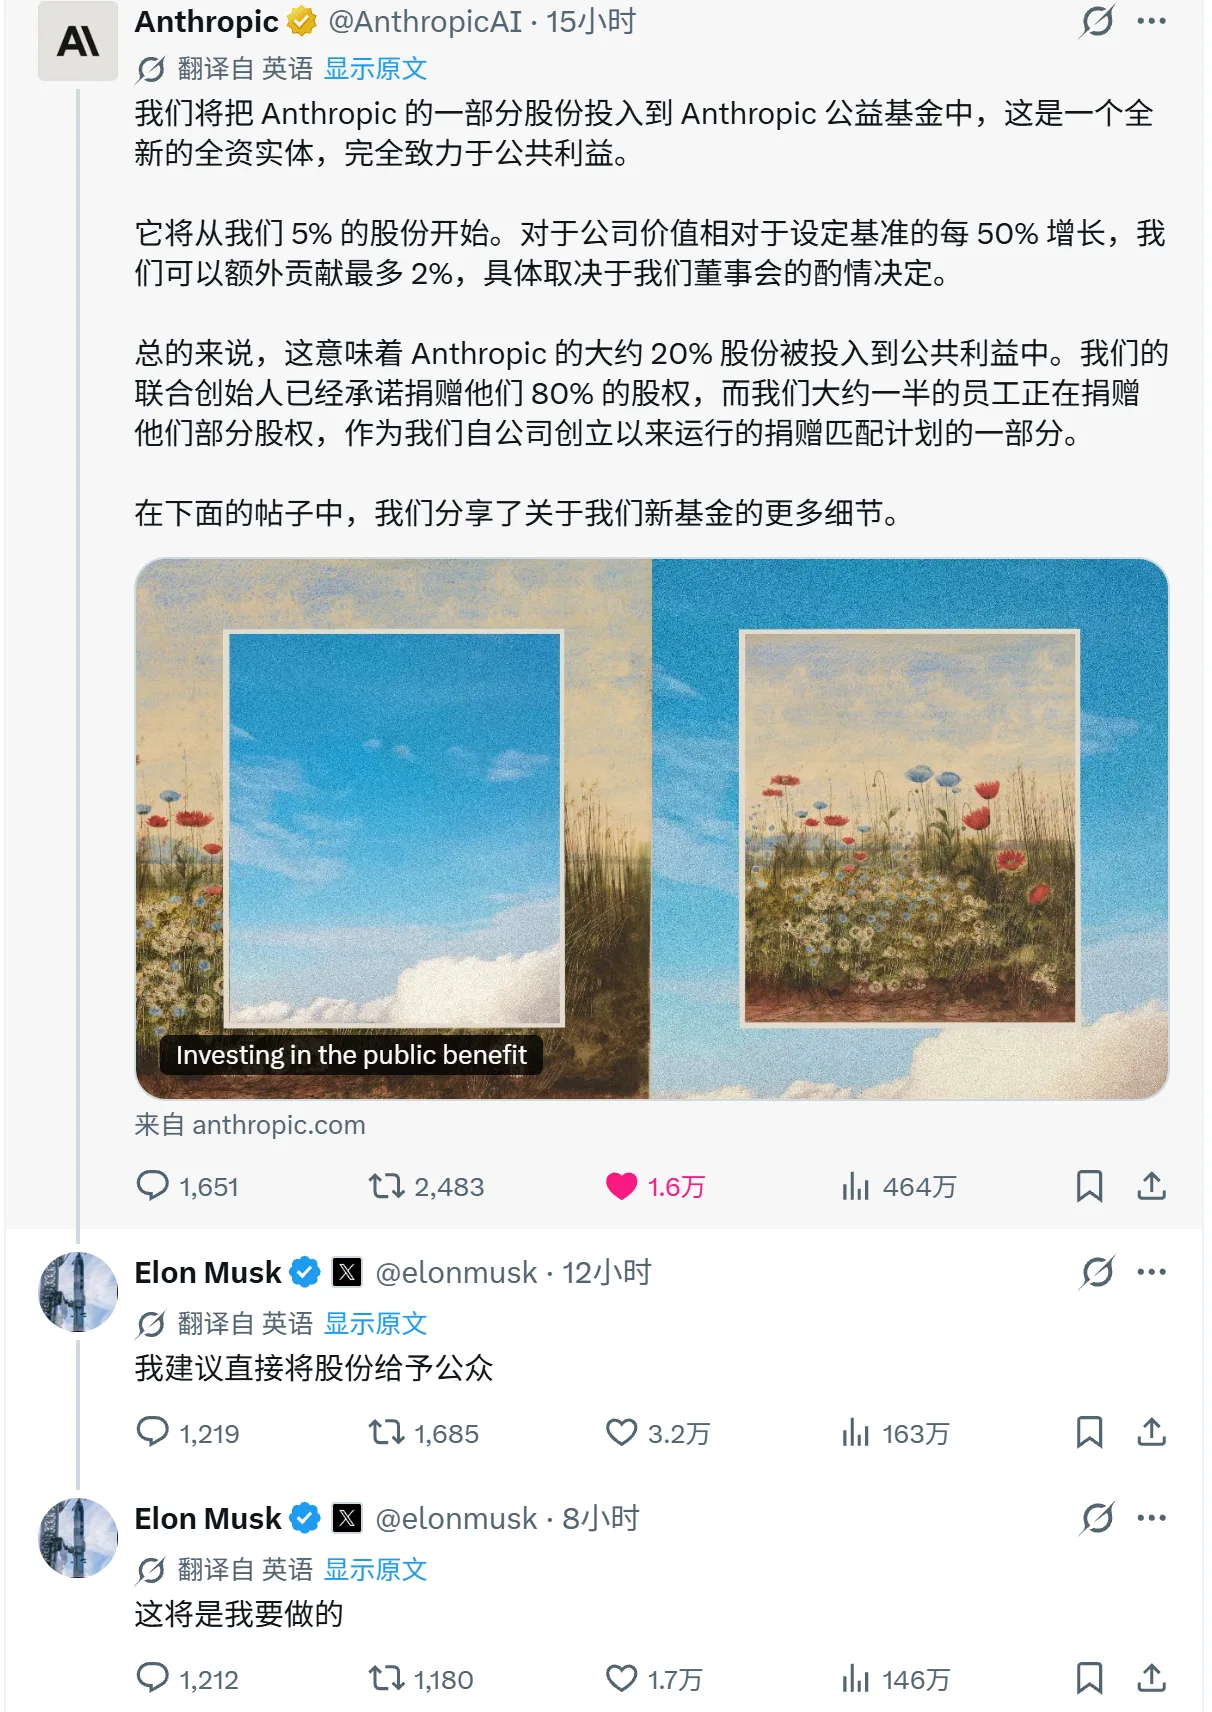
Anthropic 的一部分股份投入到 Anthropic 公益基金中,这是一个全新的全资实体,完全致力于公共利益。

Anthropic 的一部分股份投入到 Anthropic 公益基金中,这是一个全新的全资实体,完全致力于公共利益。

这种热闹老马绝对不会错过

A社带了个好头起码。

至于最终效果,我们拭目以待

海康机器人放弃上市是否和宇神上市反应不好有关?

海康机器人放弃上市是否和宇神上市反应不好有关?

海康机器人放弃上市是否和宇神上市反应不好有关?

宇树科技确实不算一家合格的可上市企业

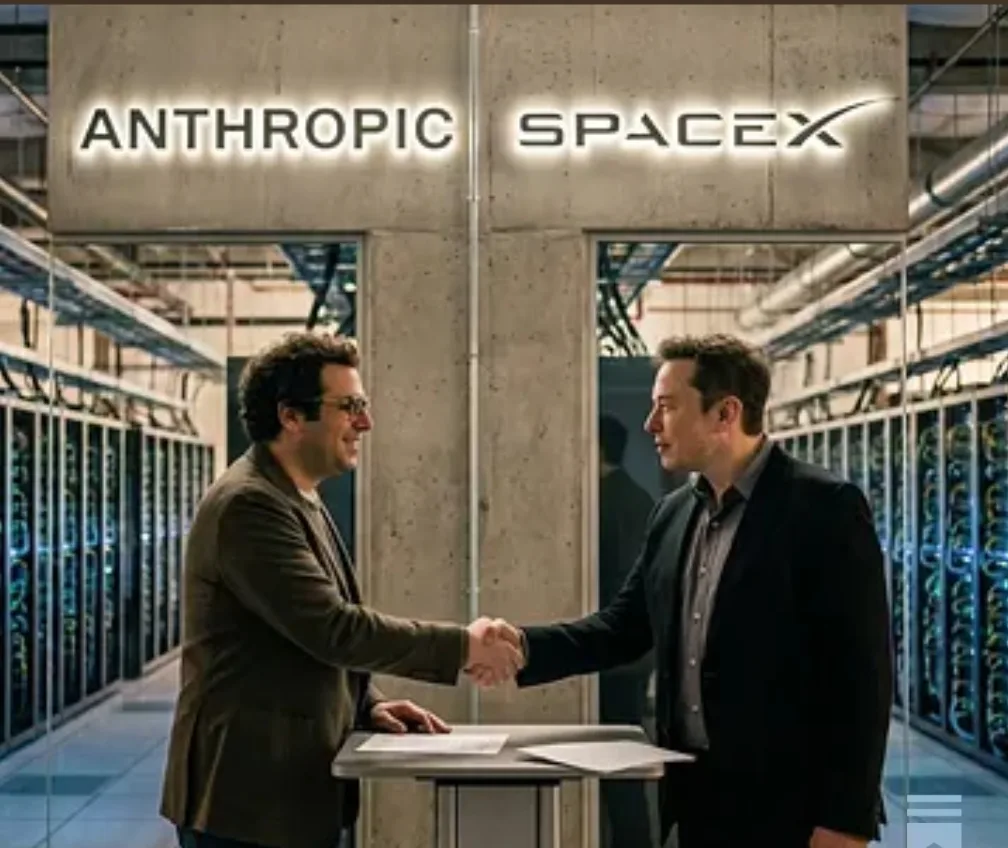
SpaceX与Anthropic 超算数据中心租赁协议深度剖析

SpaceX与Anthropic 超算数据中心租赁协议深度剖析

AI基础设施研究(一):SpaceX与Anthropic 超算数据中心租赁协议深度剖析

Anthropic 以$12.5亿/月 (年化$15o亿)租用了SpaceX的22万张顶级GPU现货集群,折合租赁单价:单卡时约$7.85/GPU-h,相比市面上的普通3年数据中心的租赁长约溢价超2o0%;这笔交易的本质是用超高溢价购买不可替代的“现货时间窗口”

JINRONGWANG.SUBSTACK.COM

金融汪

开源大模型的出路在哪里

FDE的感想,写的不错

开源大模型的出路在哪里

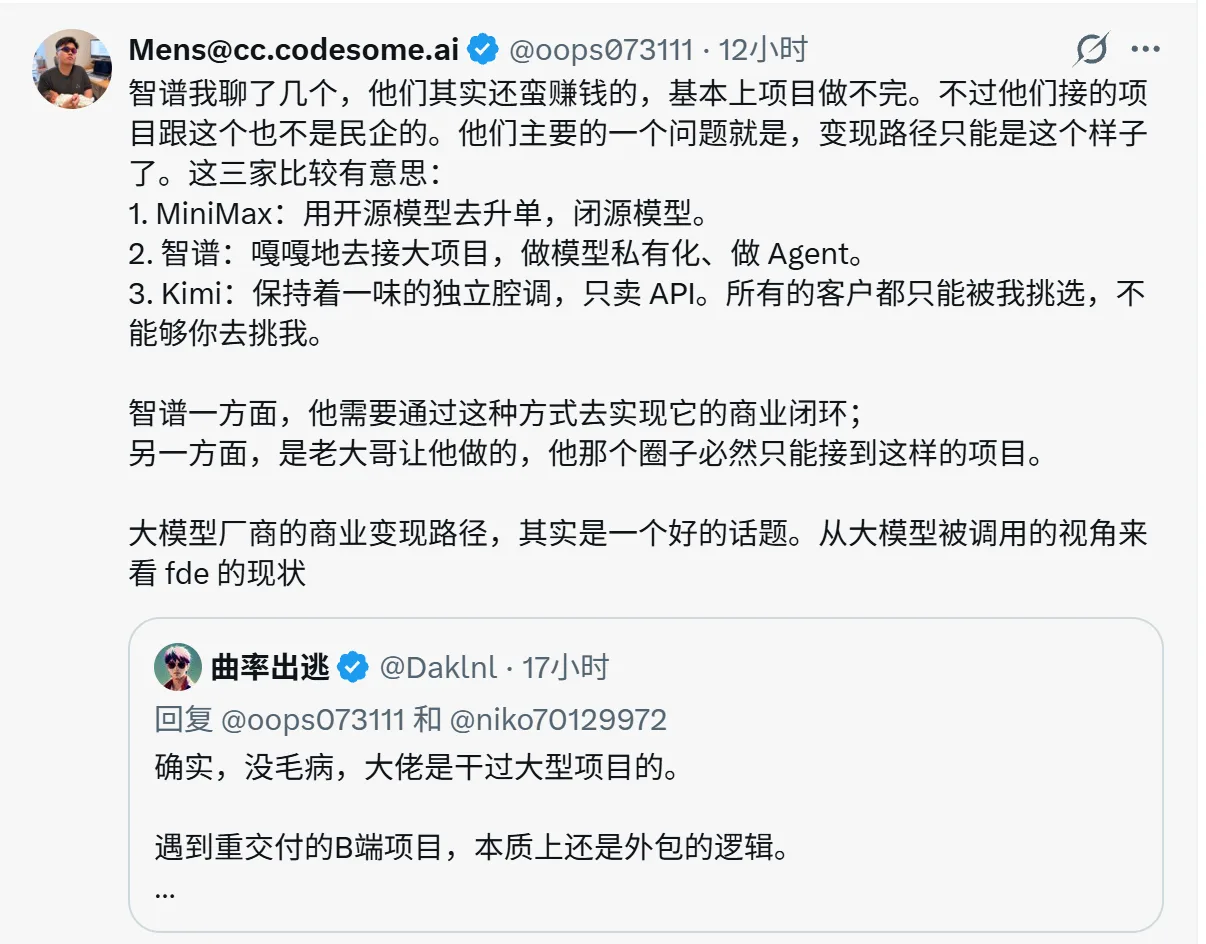
智谱我聊了几个,他们其实还蛮赚钱的,基本上项目做不完。不过他们接的项目跟这个也不是民企的。他们主要的一个问题就是,变现路径只能是这个样子了。这三家比较有意思:

  1. MiniMax:用开源模型去升单,闭源模型。
  2. 智谱:嘎嘎地去接大项目,做模型私有化、做 Agent。
  3. Kimi:保持着一味的独立腔调,只卖 API。所有的客户都只能被我挑选,不能够你去挑我。

智谱一方面,他需要通过这种方式去实现它的商业闭环;
另一方面,是老大哥让他做的,他那个圈子必然只能接到这样的项目。

大模型厂商的商业变现路径,其实是一个好的话题。从大模型被调用的视角来看 fde 的现状

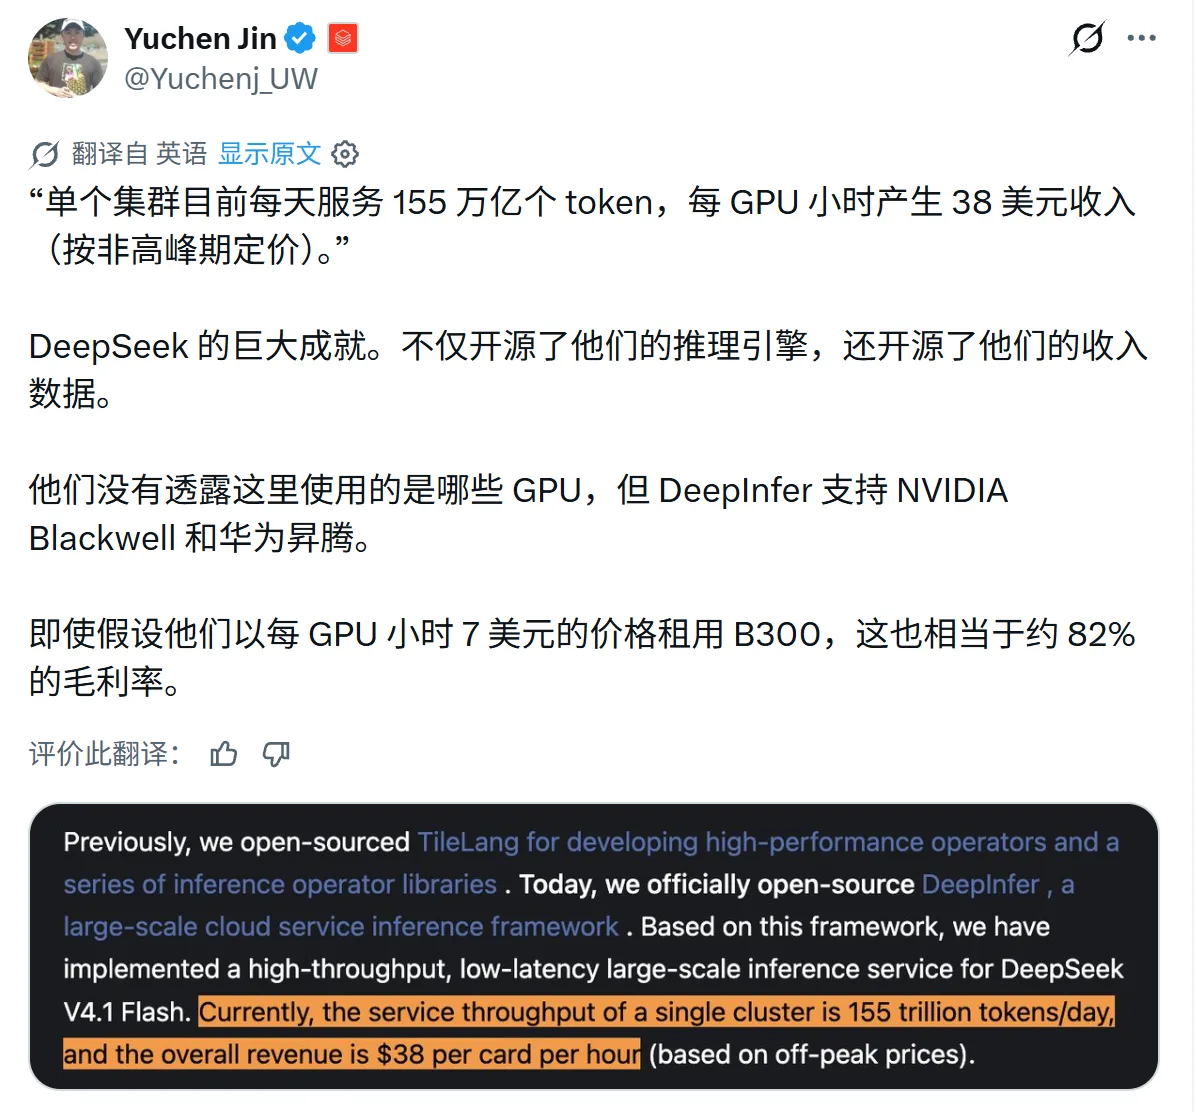
DeepSeek V4.1 Flash 大规模推理部署实践

根据当前网页中 DeepSeek 官方发布的《DeepSeek V4.1 Flash 大规模推理部署实践》,关于 V4.1 的硬件成本、收益结构及约束条件 总结如下:

一、 硬件投入与成本结构 ​

  • 异构与通用算力选型:

  • Prefill 阶段:采用市面常见的 8 卡标准机器,在显存足够前提下使用较小并行度(EP2~8 / DP2~8)。

  • Decode 阶段:采用常见的 64~128 卡超节点(Wide-EP),最大化并行度以提升 Batch Size 与矩阵乘法效率。

  • Vision Encoder:采用单卡部署,官方建议选用可用范围内最便宜的卡即可。

  • 芯片兼容性:跨平台适配英伟达与华为昇腾等多种厂商计算芯片。

  • 存储与网络基础设施:

  • 独立持久化存储:引入独立 3FS 分布式文件系统 集群,提供约 100 PiB 的 SSD 存储,专门用于存储 Block KVCache(约 112 KiB 随机读写,峰值聚合读带宽达 10 TiB/s,写带宽约 850 GiB/s)。

  • 网络与内存换入:跨机 SWA KVCache 拉取使用 400G VLAN;显存与主机 shm 数据换入采用 GDR 技术,利用 RDMA 打满 PCIe 带宽,避免占用 GPU SM 算力。

  • 计算开销优化(降低算力冗余):

  • SWA Bounded Replay:放弃了 V4 技术报告中极占 SSD 容量的精确落盘与长序列重算,转为只重算最近 128 个 token,使前向与解码重算代价降为常数,总 Prefill 计算量近乎减半。


二、 收益与产出结构 ​

  • 集群服务吞吐:单一集群服务吞吐达到 155 万亿 Tokens/天。

  • 商业/算力变现收益:按低谷电/算力价格(谷价)计算,整体收入达到 每卡每小时 38 美金。

  • KVCache 复用收益:

  • Agent 流量的 KVCache 保留时长(TTL)达 3 天(72 小时以上),Chatbot 流量达 7 天,大幅减少长上下文及 Agent 场景的 Prefill 重复计算开销。

  • 短期 SWA KVCache 内存池周转生命周期约 180 秒,线上命中率达 98% 以上。

  • 解码加速收益:配合 DSpark 变长验证投机解码,相比固定验证 5 个 token,在线部署场景吞吐提升了 6%;同时借助异步调度实现 GPU 无缝打满(全程无空闲)。


三、 核心约束条件与系统边界 ​

  1. 硬件与拓扑约束:
  • 大通信域单点故障风险:在 Wide-Decode(EP64~128)下,整个实例内全部显卡构成单一通信域,任意一张卡故障会导致整个实例不可用,重启恢复达分钟级。
  • 容错与弹性机制:必须依赖配额冗余(占用率 > 0.8 时禁止缩容)和请求级动态重新路由;重启时需按当前存活的健康卡动态重定 EP 规模。
  1. SWA 截断与重算约束:
  • 最大前缀命中长度受 YOCO 截断约束,上限为 L−134(128 窗口 + 6 投机回退)。
  • SWA KVCache 必须对齐 128 tokens 整数倍存储;若 SWA 未命中,必须回退 128 tokens 进行 Bounded Replay 重算。
  1. 负载均衡多维约束:
  • Decode 阶段:需同时约束并平衡“并发请求数”(决定 Batch 大小)与“KVCache 总长度”(决定注意力开销)两个维度。
  • Prefill 阶段:依赖拟合的二次代价模型 cost(q,c) 按纳秒级时间预算动态反解切分 token 数(Chunk Size 不固定)。
  • 动态扩缩容下线延迟:Decode 实例缩容下线设置了 1 分钟宽限期,以防长尾请求被直接中断,超时后未完成请求及缓存需全量转发迁出。

DeepSeek的4.1 Flash假如部署在美国,租用的服务器成本在7美元/小时 大概有82&的毛利(比较了Anthropic租的X的最新订单150亿美元的合同大概就是这个价格附近)

DeepSeek的4.1 Flash假如部署在美国,租用的服务器成本在7美元/小时 大概有82&的毛利(比较了Anthropic租的X的最新订单150亿美元的合同大概就是这个价格附近)

是的,这就是 Anthropic(A社)跟 SpaceX/xAI 签的那笔大单。

根据 SpaceX 的 S-1 文件和后续披露,核心条款是:

  • Anthropic 每月支付 12.5 亿美元(年化约 150 亿美元),合同到 2029 年 5 月。
  • 主要租用 Colossus 1 的全部容量:约 22 万张 NVIDIA GPU(H100、H200、GB200 混合)+ 300+ MW 电力。
  • 双方都有 90 天解约条款(前几个月有优惠价,之后满额)。
  • 部分后续披露/修正把范围扩到 Colossus 1 + Colossus 2,GPU 数量提到约 32.5 万张左右。

折合单卡时价格水平 ​

中文圈(尤其金融汪等)用最常见的 22 万张 GPU 来算,得到的是:

  • 约 $7.8–$7.85 / GPU-小时($12.5 亿 ÷ 22 万 ÷ 730 小时 ≈ 这个数)。

如果按更高的 32.5 万张来算,会降到约 $5.27 / GPU-小时。

这个价格是全包的(电力、冷却、网络、存储、机房都包含在内),不是单纯裸卡租赁。

跟当前市场比是什么水平? ​

  • 跟你前面问的 B300 公开租赁价(美国 on-demand 大约 $6.5–$9.5,中位 $8 左右)比,$7.8 左右基本在市场中低到中等水平,并不离谱。
  • 但跟长期 Reserved / 3 年承诺合同(很多时候能到 $4–$6 甚至更低)比,确实有明显溢价。中文分析里说“比普通 3 年数据中心租赁溢价超 200%”,指的就是这个对比。
  • 它贵在现货、大规模、即插即用、专用容量。当时美国算力供应紧张,Anthropic 急需立即扩容,xAI 那边 Colossus 1 利用率又很低(有报道说训练迁到 Colossus 2 后利用率只有约 11%),所以双方达成了这个“高溢价换时间窗口”的交易。

总结:
这笔 150 亿美元/年的交易,按主流口径(22 万张卡)折合单卡时大约 $7.8,跟当前美国公开市场上 B300 的 on-demand 价格基本处于同一水平,属于“现货大规模专用容量”的合理偏高价,而不是极端高价。它本质上是 Anthropic 在算力短缺窗口期,用溢价锁定了 xAI/SpaceX 的现成集群。

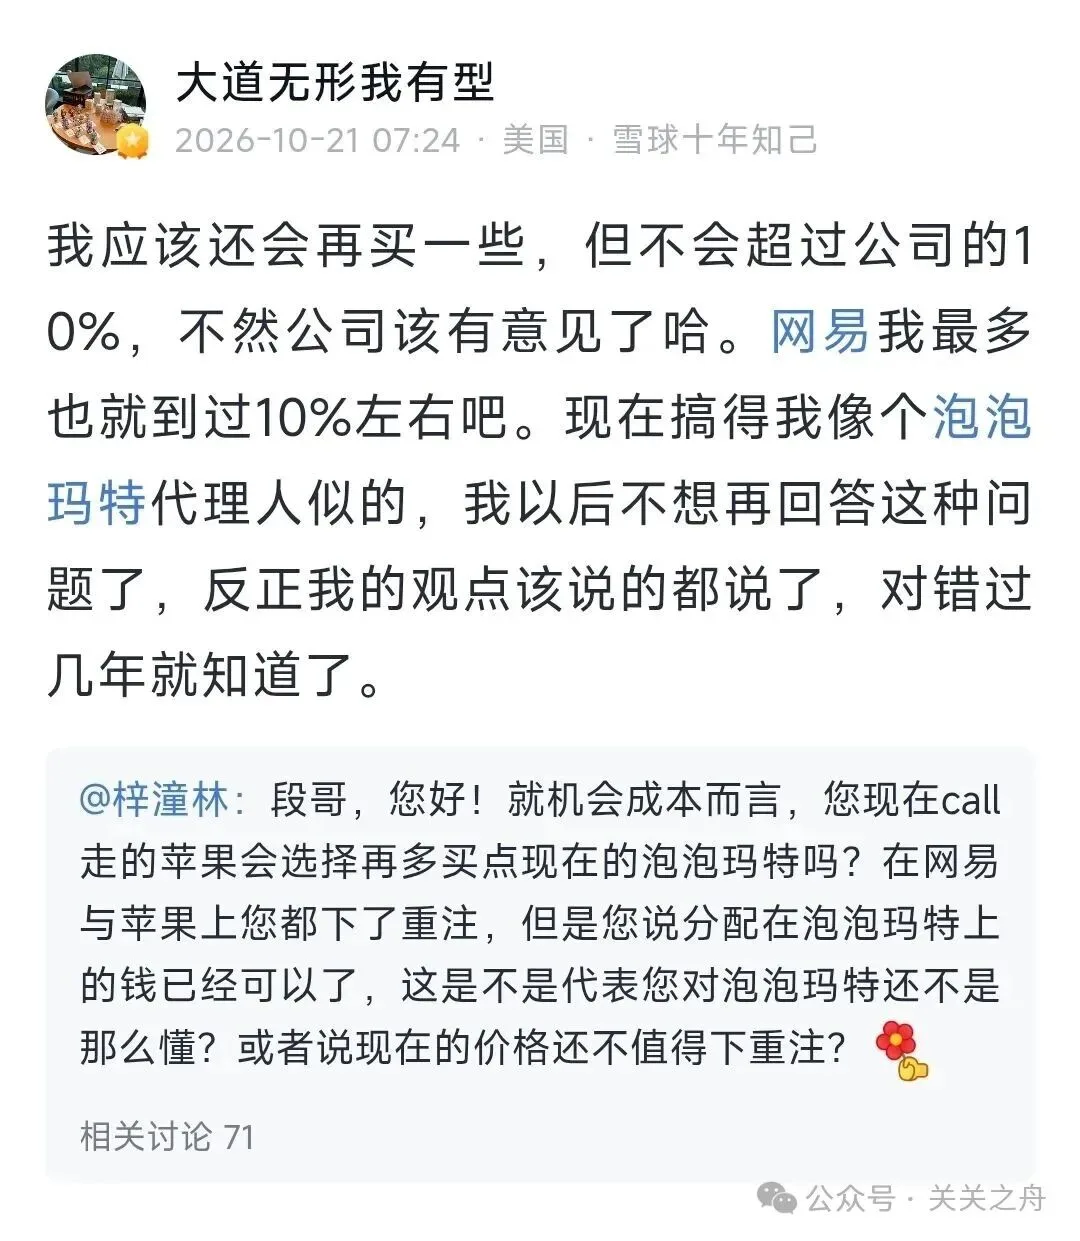
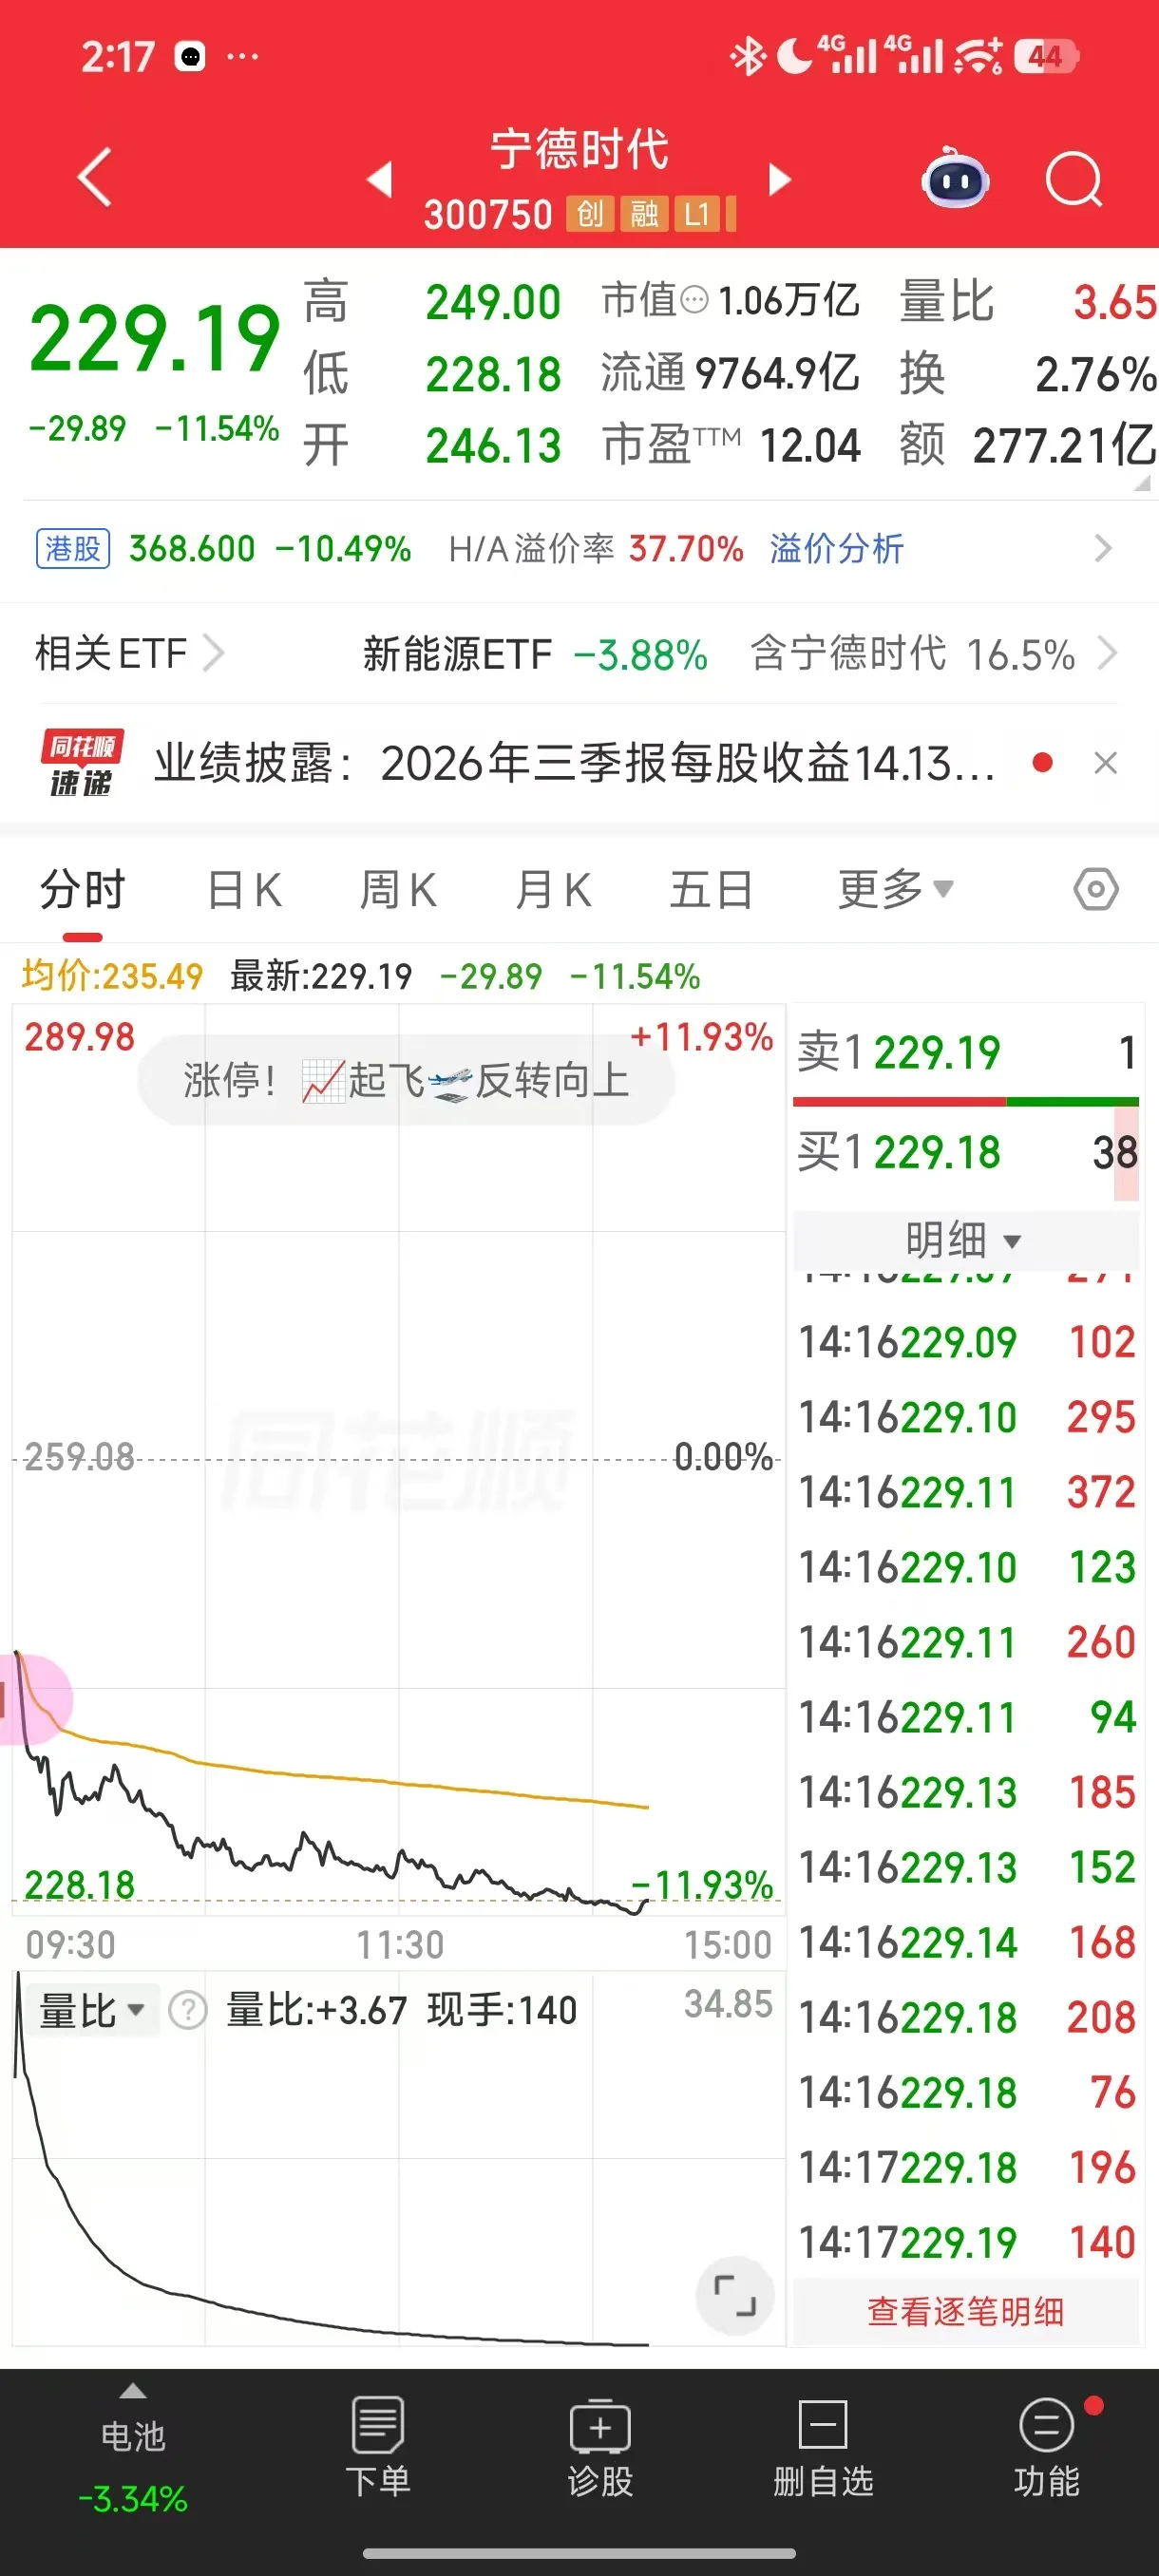
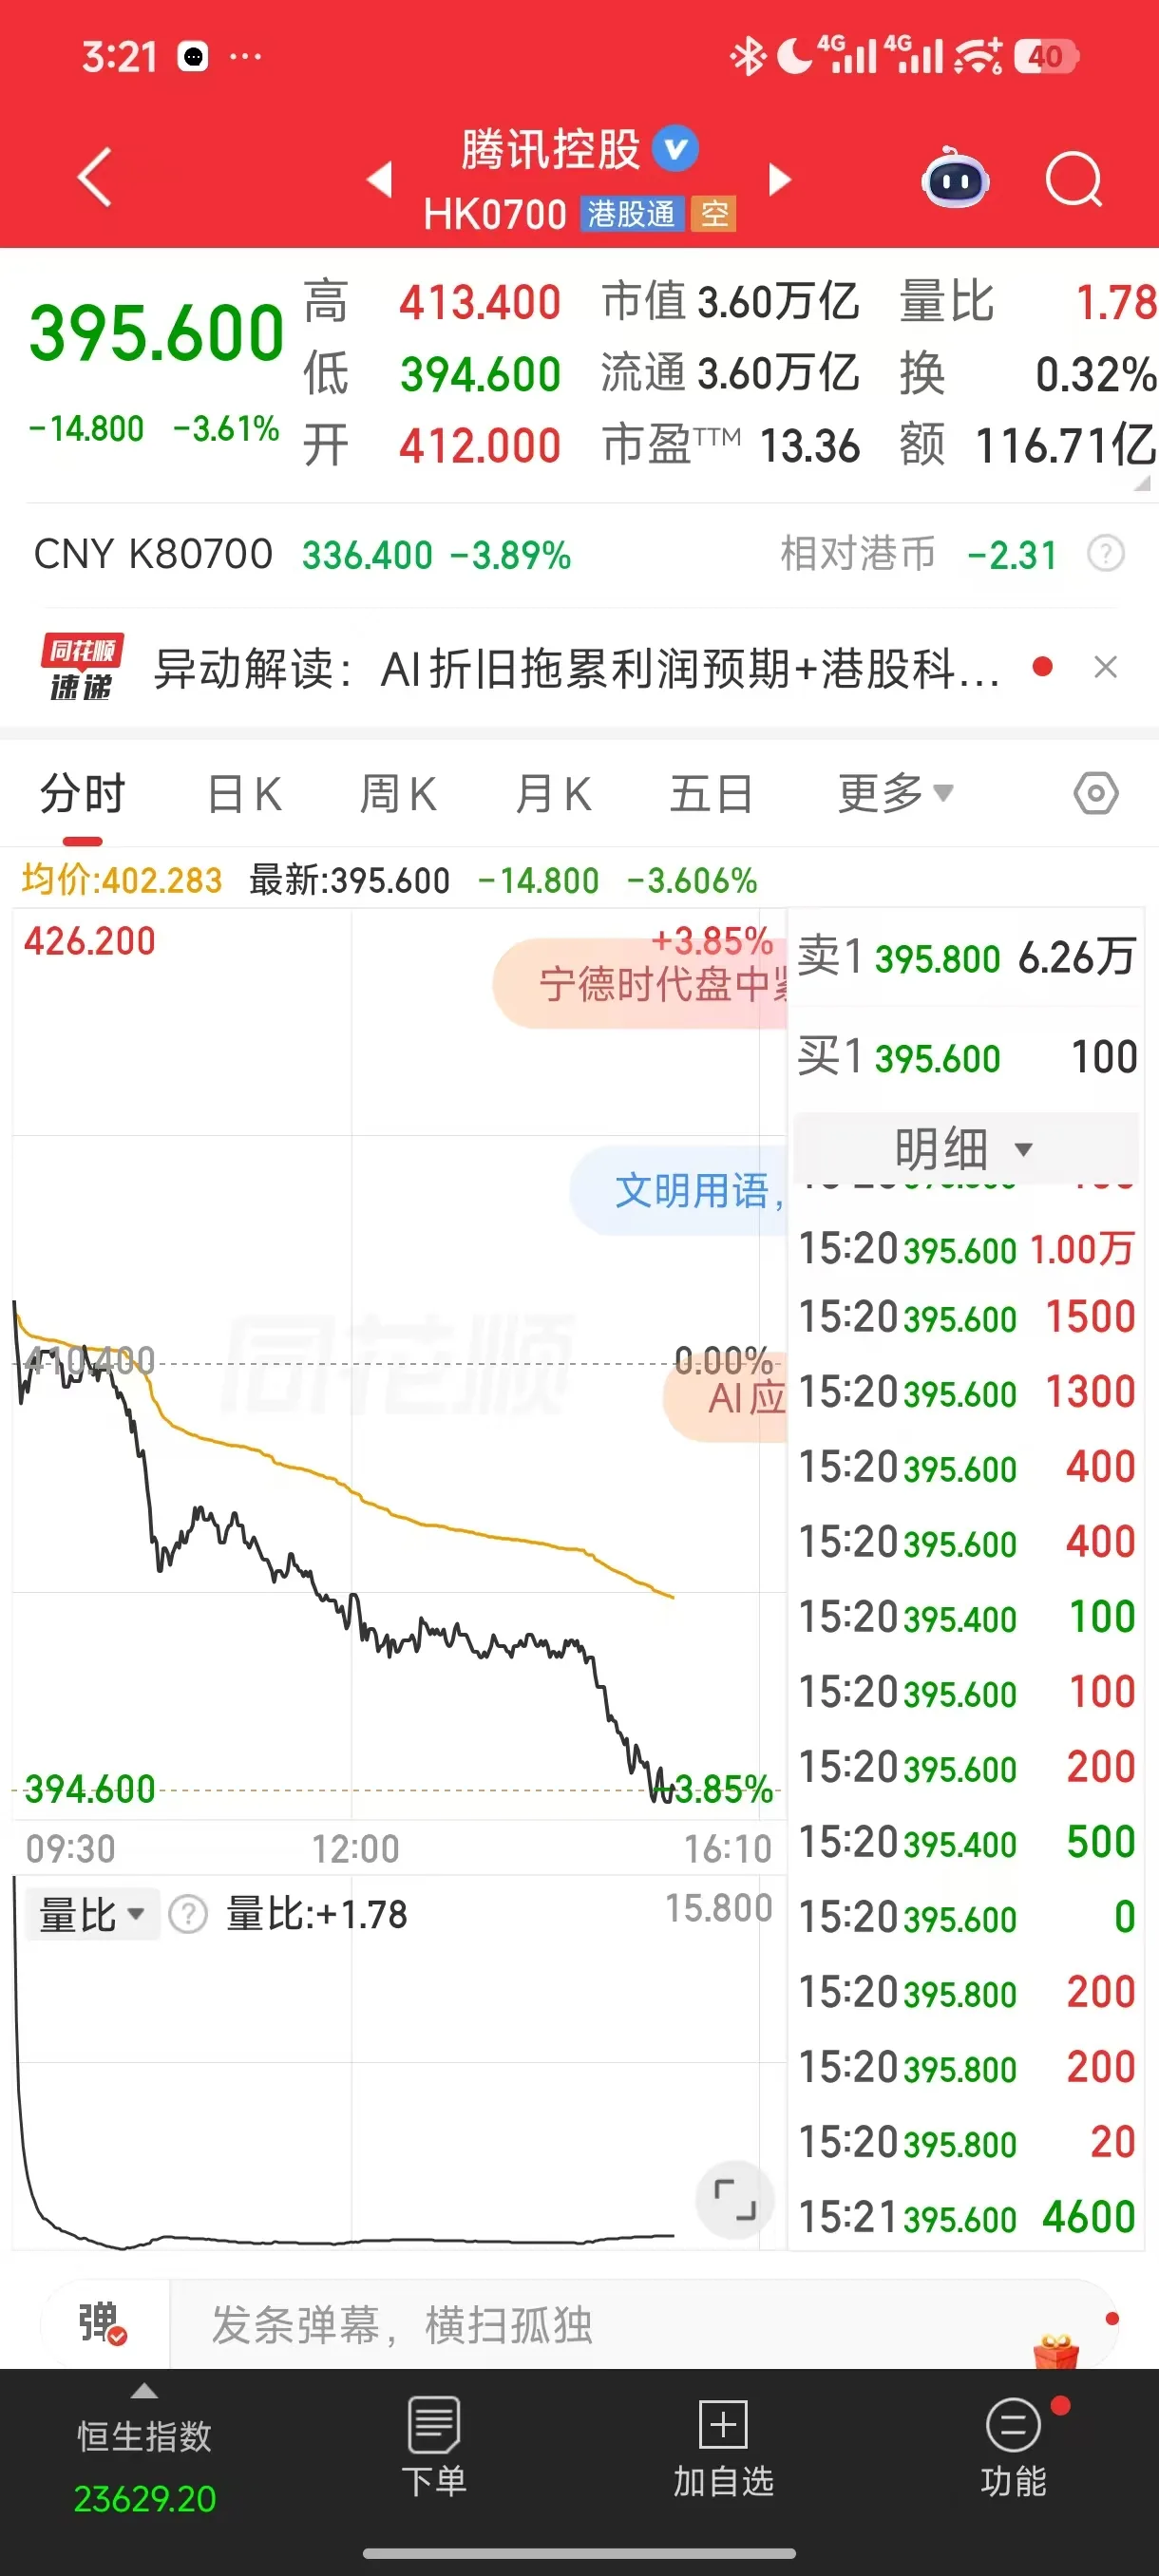
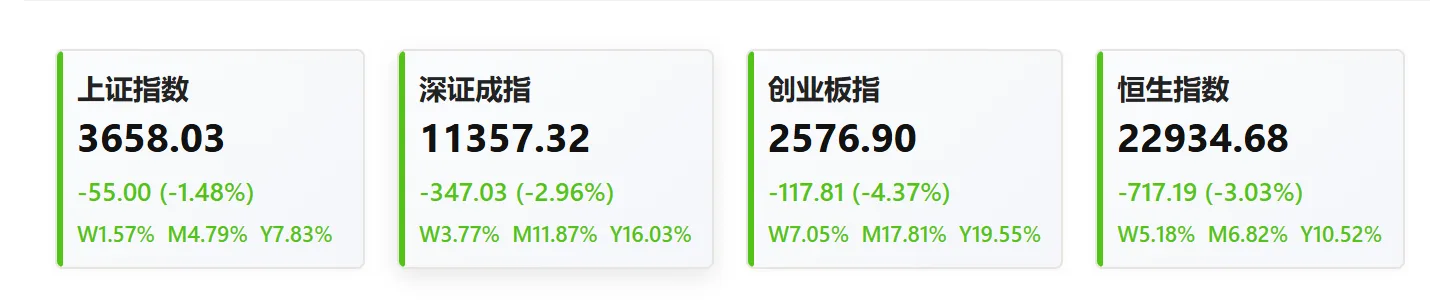
泡泡崩完宁德崩,宁德崩完腾讯崩

泡泡崩完宁德崩,宁德崩完腾讯崩

泡泡崩完宁德崩,宁德崩完腾讯崩

泡泡崩完宁德崩,宁德崩完腾讯崩

非常惨烈,关键是港股比A股还惨烈

非常惨烈,关键是港股比A股还惨烈

非常惨烈,关键是港股比A股还惨烈

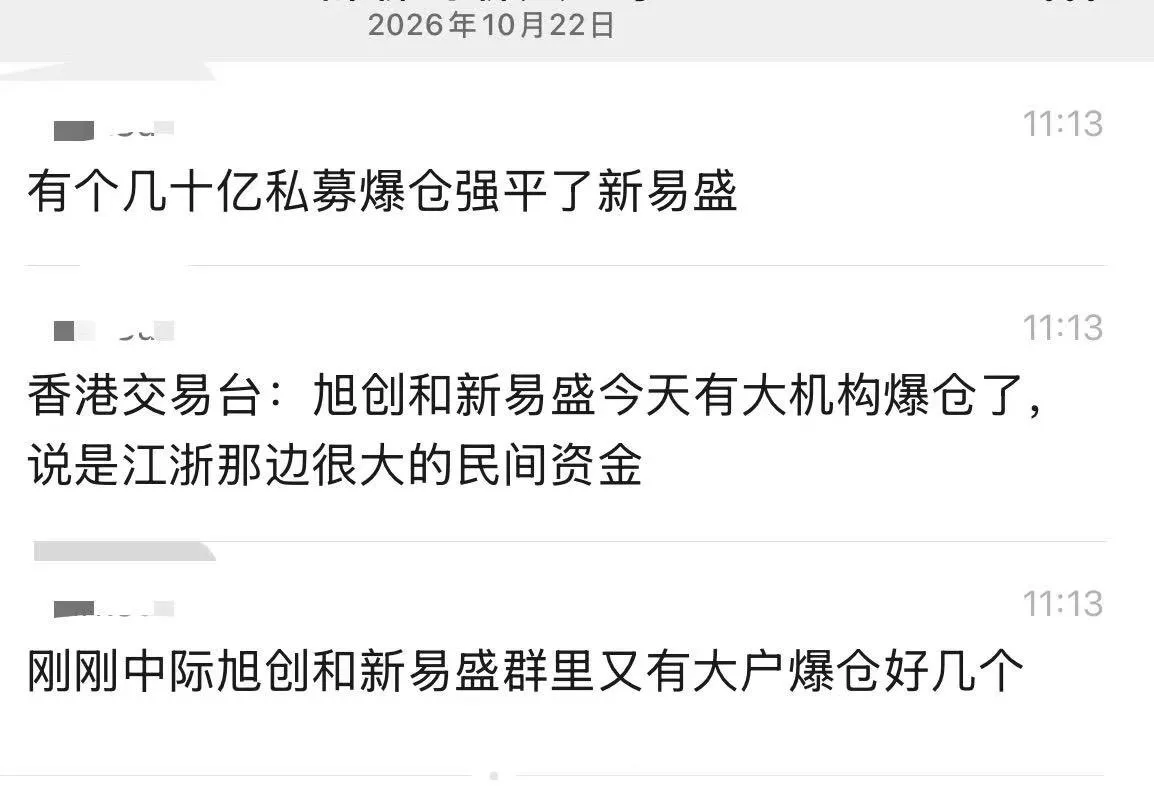
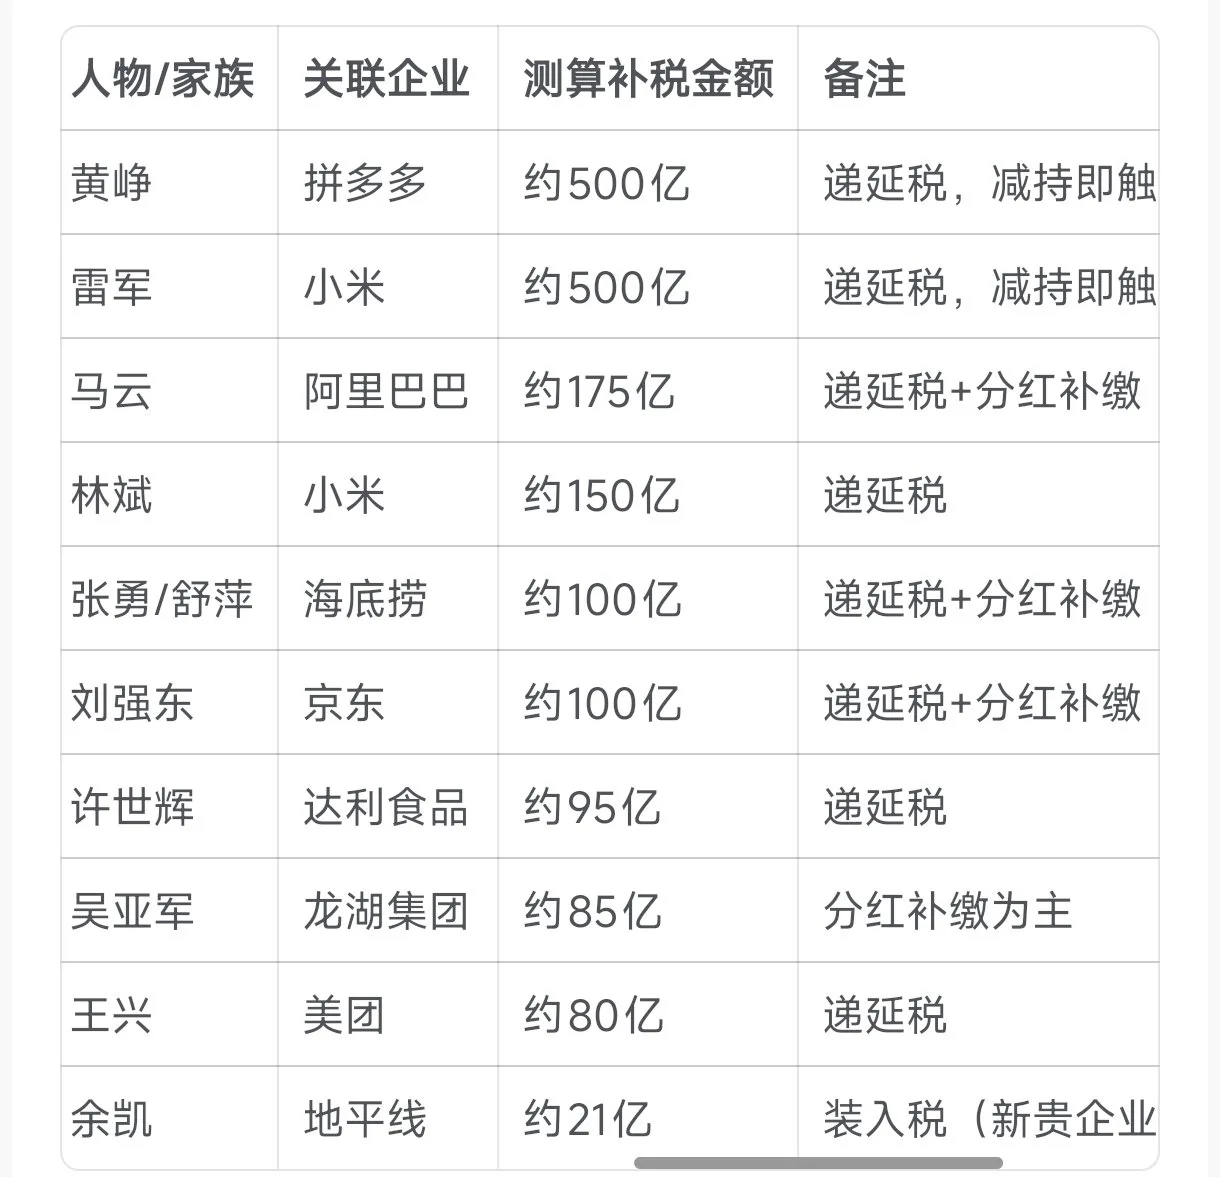
新税制导致离岸信托将成为过去

富豪补税带崩港股?

离岸信托税收新规:对话总结 ​

一、核心结论 ​

中国2026年离岸信托税收新规,最重要的变化不是提高税率,而是改变了纳税时点:把部分原本可能等到股票出售后才缴纳的资本利得税,提前到了股权装入离岸信托时。

这可能造成一个问题:

创始人没有卖出股票、没有获得现金,却因为将股权装入信托而产生巨额税款,最终可能被迫减持或质押股票。

这是本轮讨论中最值得关注的政策争议。

二、我们形成的六点认识 ​

1. 直接持有股票与装入离岸信托,税务处理不同。

对于中国税收居民个人,直接持有上市公司股票,即使股价上涨几十倍,只要没有发生应税转让,通常不需要为账面增值缴纳资本利得税。

但把升值股权装入适用新规的离岸信托,即使没有实际出售,也可能产生纳税义务。

2. 税款按完整的历史增值计算,不是只计算上市后的涨幅。

一般计算方式:

应纳税额=(装入时公允价值−计税成本−合理费用)×20%

原始成本通常需要通过实际出资、股份取得、历史重组等资料确定,并由税务机关核查。公司上市本身不会自动把原始计税成本提高到IPO价格。

3. 离岸信托新规主要堵住税收递延空间。

过去,中国已经有全球所得征税和反避税规定,但离岸信托部分环节的税务处理不够明确。

新规进一步明确了资产装入、信托存续收益及终止清算等环节的征税规则。

因此,过去的离岸信托不能一概称为合法免税工具,新规也不只是简单取消某项既有免税优惠。

4. 中国的装入环节规则相对严格,但不是国际独有。

美国对某些外国信托也要求立即确认资产增值;英国部分信托可以符合条件地递延资本利得税;日本和美国某些信托可以在税务意义上的资产所有人未改变时,不立即确认转让所得。

所以更准确的评价是:

中国新规针对离岸信托装入环节的即时征税要求较严格,缺少部分国家针对特定信托设置的明确递延例外。

但不能笼统认为欧美日韩都允许离岸信托延税。

5. 政策目标与经济后果需要分开评价。

反避税目标具有明确的税收征管逻辑。

但政策可能没有充分区分以财富传承、长期持股为目的的信托,与以规避或长期递延纳税为目的的安排。

对于历史成本低、当前市值高的创始人股权,集中纳税可能造成较大现金流压力。

6. 富豪被迫卖股具有合理机制,但不能直接解释港股整体下跌。

已披露案例说明,部分富豪确实在减持股票或寻求融资。

但缺少补税相关减持的总体规模及市场影响数据,因此不能证明这轮补税是恒生科技指数大跌的重要原因。

三、以 MiniMax 为例 ​

我们讨论了港股上市公司 MiniMax(稀宇科技)。

招股书披露,创始人闫俊杰通过 Alpha EXP 相关架构持有约6,259万股,并在上市前设立了家族信托。

但需要明确区分:

概念含义
股票面值公司设立时确定的名义金额
IPO价格上市时公开发行股票的价格
装入信托时的公允价值判断装入环节应税增值的重要依据
原始计税成本通过实际取得股份、出资及历史调整确定的税务成本

不能把股票面值直接当作创始人的原始计税成本,也不能直接用IPO价格计算上市前装入信托时的税款。

目前公开资料不足以准确确定闫俊杰的个人计税成本、相关股份装入信托时的公允价值及实际税务义务。

另外,MiniMax存在境外控股架构,需要进一步区分装入信托的是上市公司股份还是中间持股公司的股权。

四、整个讨论的逻辑链 ​

创始人长期持有升值股权

没有出售,也没有取得现金

为了传承或治理,将股权装入离岸信托

新规可能要求确认历史增值所得

即使没有实际变现

产生大额现金纳税需求

可能出现股票减持、质押融资或调整持股架构

具体影响取决于资金储备及税款规模

五、最后归纳为一个三段论 ​

假设: 创始人将长期持有的股权装入离岸信托,主要用于财富传承与股权管理,实际并不准备出售。

推演: 中国2026年新规可能在装入信托时,对此前积累的股权增值征税,使创始人在没有实际现金收入的情况下承担纳税义务,增加被迫出售或质押股票的可能性。

结论: 新规有助于堵住利用离岸信托递延和规避税收的空间,但也可能提高正常长期持股型信托的经济成本。因此,其反避税目标与即时征税方式之间,存在值得讨论的政策权衡。

整个对话最终凝练成一个问题:

如果创始人只是改变股权持有形式,没有出售股份,也没有实质改变经济受益关系,税法是否应该立即对多年累积、尚未变现的股权增值征税?

这既是中国离岸信托新规中值得研究的争议,也是比较不同国家税收制度设计时最重要的切入点。

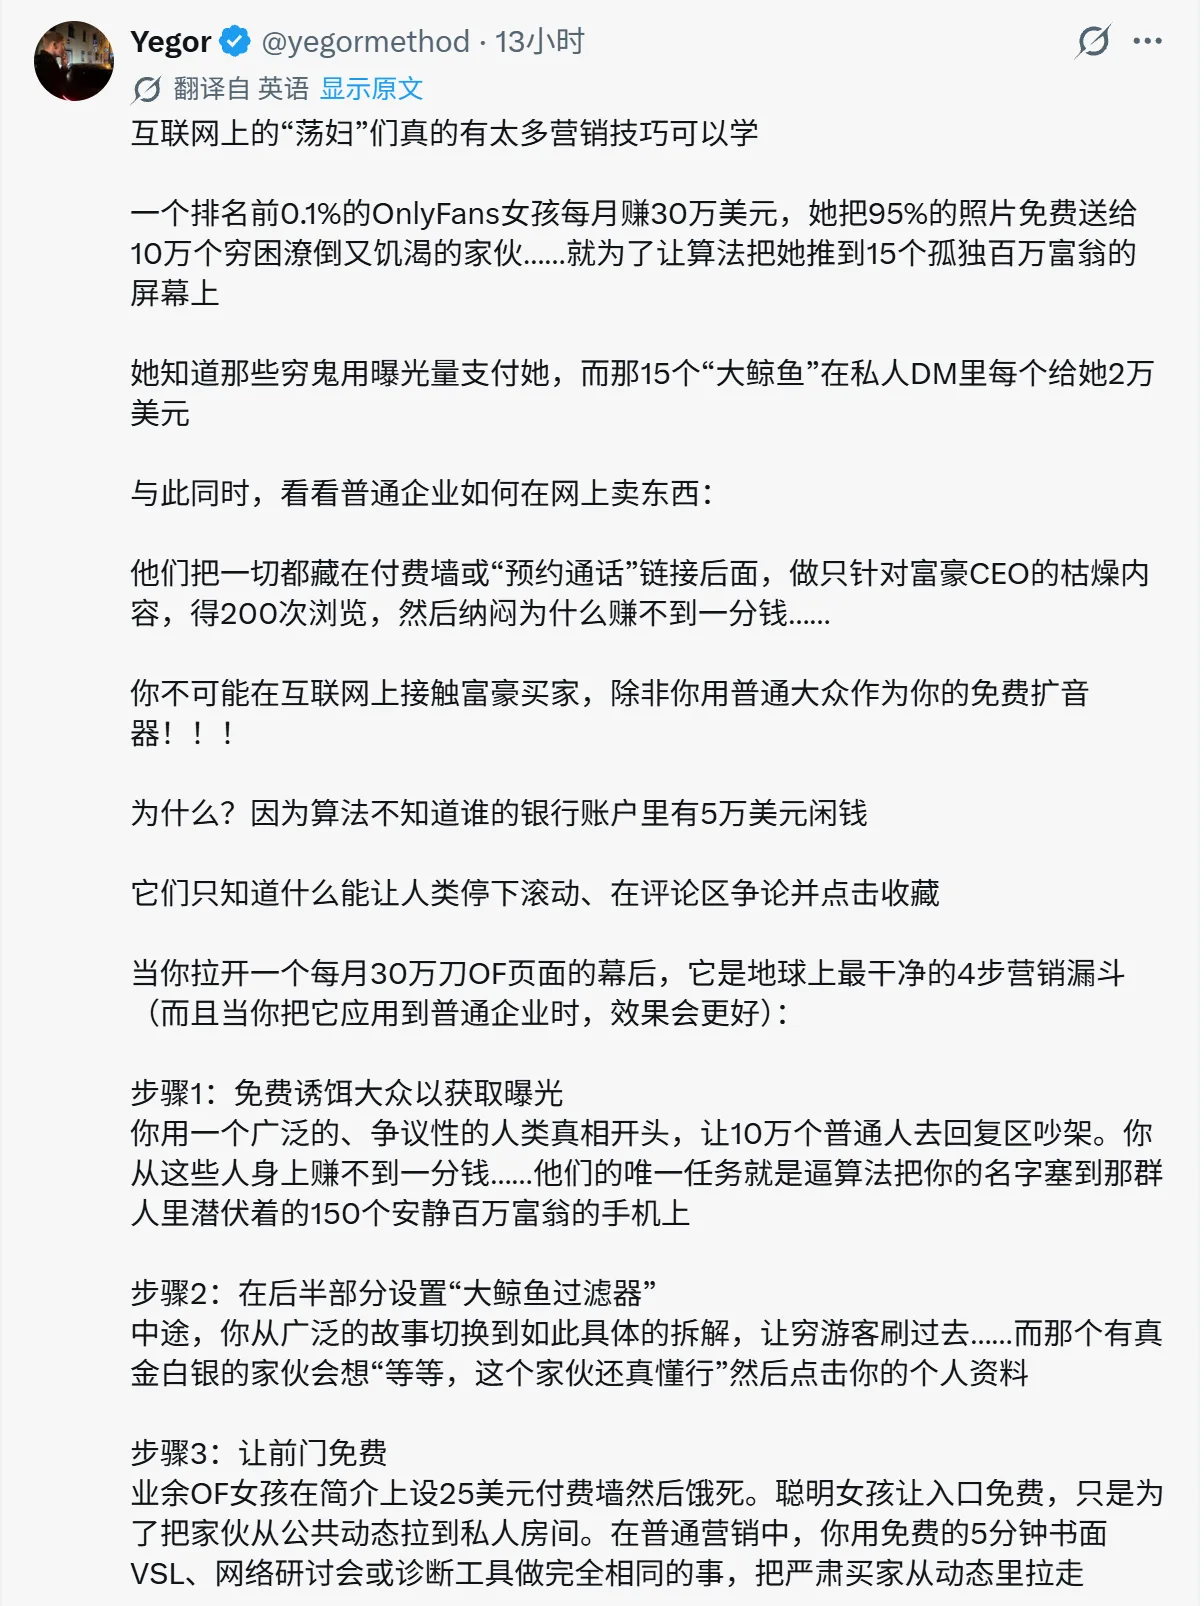
互联网上的“荡妇”们的营销技巧

互联网上的“荡妇”们的营销技巧

互联网上的“荡妇”们真的有太多营销技巧可以学

一个排名前0.1%的OnlyFans女孩每月赚30万美元,她把95%的照片免费送给10万个穷困潦倒又饥渴的家伙……就为了让算法把她推到15个孤独百万富翁的屏幕上

她知道那些穷鬼用曝光量支付她,而那15个“大鲸鱼”在私人DM里每个给她2万美元

与此同时,看看普通企业如何在网上卖东西:

他们把一切都藏在付费墙或“预约通话”链接后面,做只针对富豪CEO的枯燥内容,得200次浏览,然后纳闷为什么赚不到一分钱……

你不可能在互联网上接触富豪买家,除非你用普通大众作为你的免费扩音器!!!

为什么?因为算法不知道谁的银行账户里有5万美元闲钱

它们只知道什么能让人类停下滚动、在评论区争论并点击收藏

当你拉开一个每月30万刀OF页面的幕后,它是地球上最干净的4步营销漏斗(而且当你把它应用到普通企业时,效果会更好):

步骤1:免费诱饵大众以获取曝光
你用一个广泛的、争议性的人类真相开头,让10万个普通人去回复区吵架。你从这些人身上赚不到一分钱……他们的唯一任务就是逼算法把你的名字塞到那群人里潜伏着的150个安静百万富翁的手机上

步骤2:在后半部分设置“大鲸鱼过滤器”
中途,你从广泛的故事切换到如此具体的拆解,让穷游客刷过去……而那个有真金白银的家伙会想“等等,这个家伙还真懂行”然后点击你的个人资料

步骤3:让前门免费
业余OF女孩在简介上设25美元付费墙然后饿死。聪明女孩让入口免费,只是为了把家伙从公共动态拉到私人房间。在普通营销中,你用免费的5分钟书面VSL、网络研讨会或诊断工具做完全相同的事,把严肃买家从动态里拉走

步骤4:在3条DM中把游客和鲸鱼分开
一个训练有素的聊天手在DM里问2个随意问题,找出那1%有真实预算的人,然后只把那些大鲸鱼移到定制通话中,他们以10倍价格成交

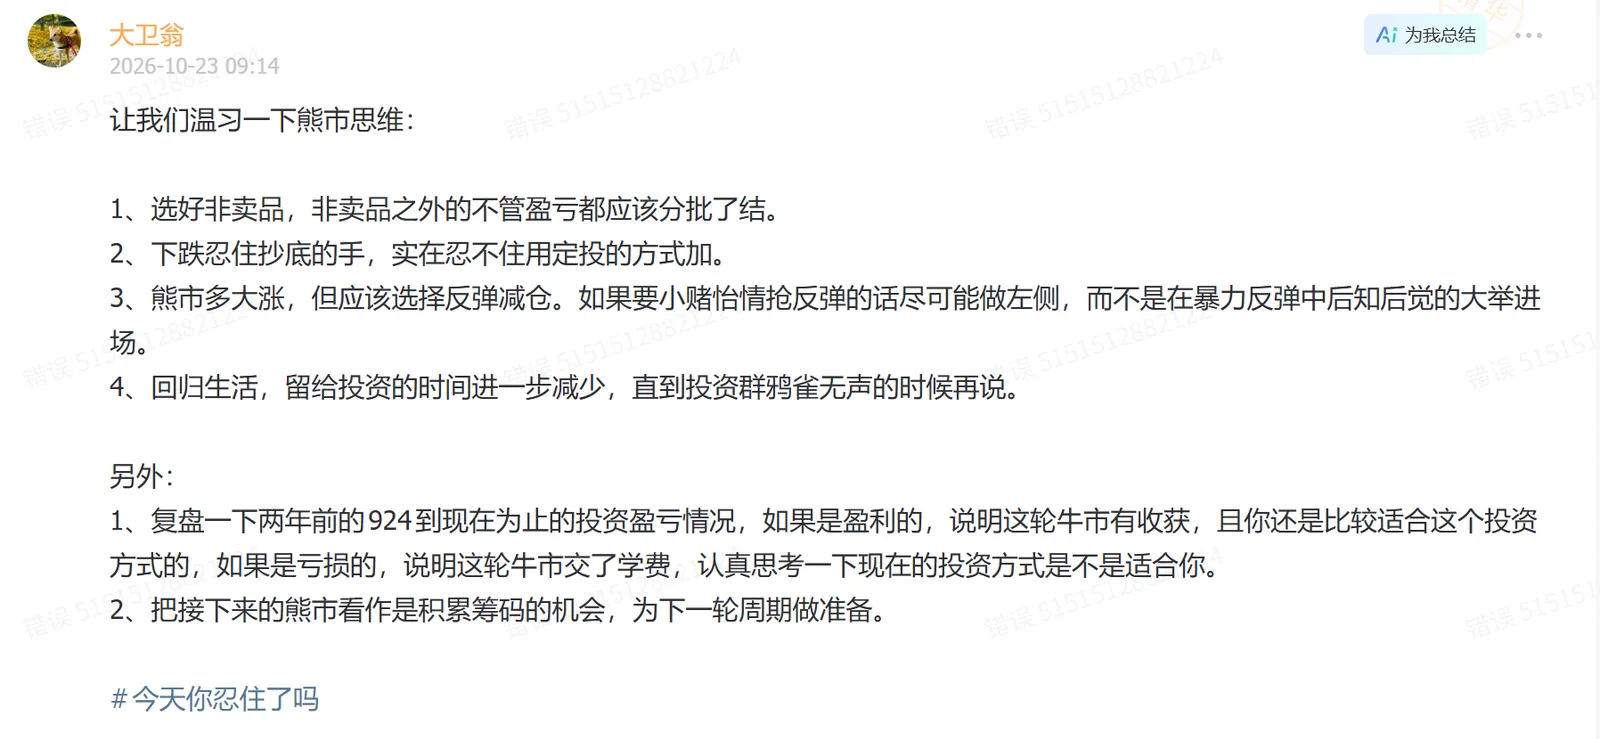
熊市操作守则

熊市操作守则

不错的建议

10位顶级富豪通过离岸信托持有的美元资产,强制补税。

10位顶级富豪通过离岸信托持有的美元资产,强制补税。

值得记录,税收还是要缴纳的

个人笔记分享 · 非投资建议,据此决策风险自负

闽ICP备2026032381号-1闽公网安备35018302000421号